Data Lake com AWS: Governança, Escalabilidade e Insights na Nuvem
A CloudDog apresenta uma solução de Data Lake de alta eficiência, aproveitando os poderosos serviços da Nuvem AWS para otimizar a organização e análise de dados. Nossa arquitetura inclui o AWS Lake Formation para uma gestão centralizada e segura do catálogo de dados, garantindo governança robusta e descoberta simplificada. Usamos S3 para armazenar, Glue para ETL, Athena para consultas e Step Functions com EventBridge para automação.
Características
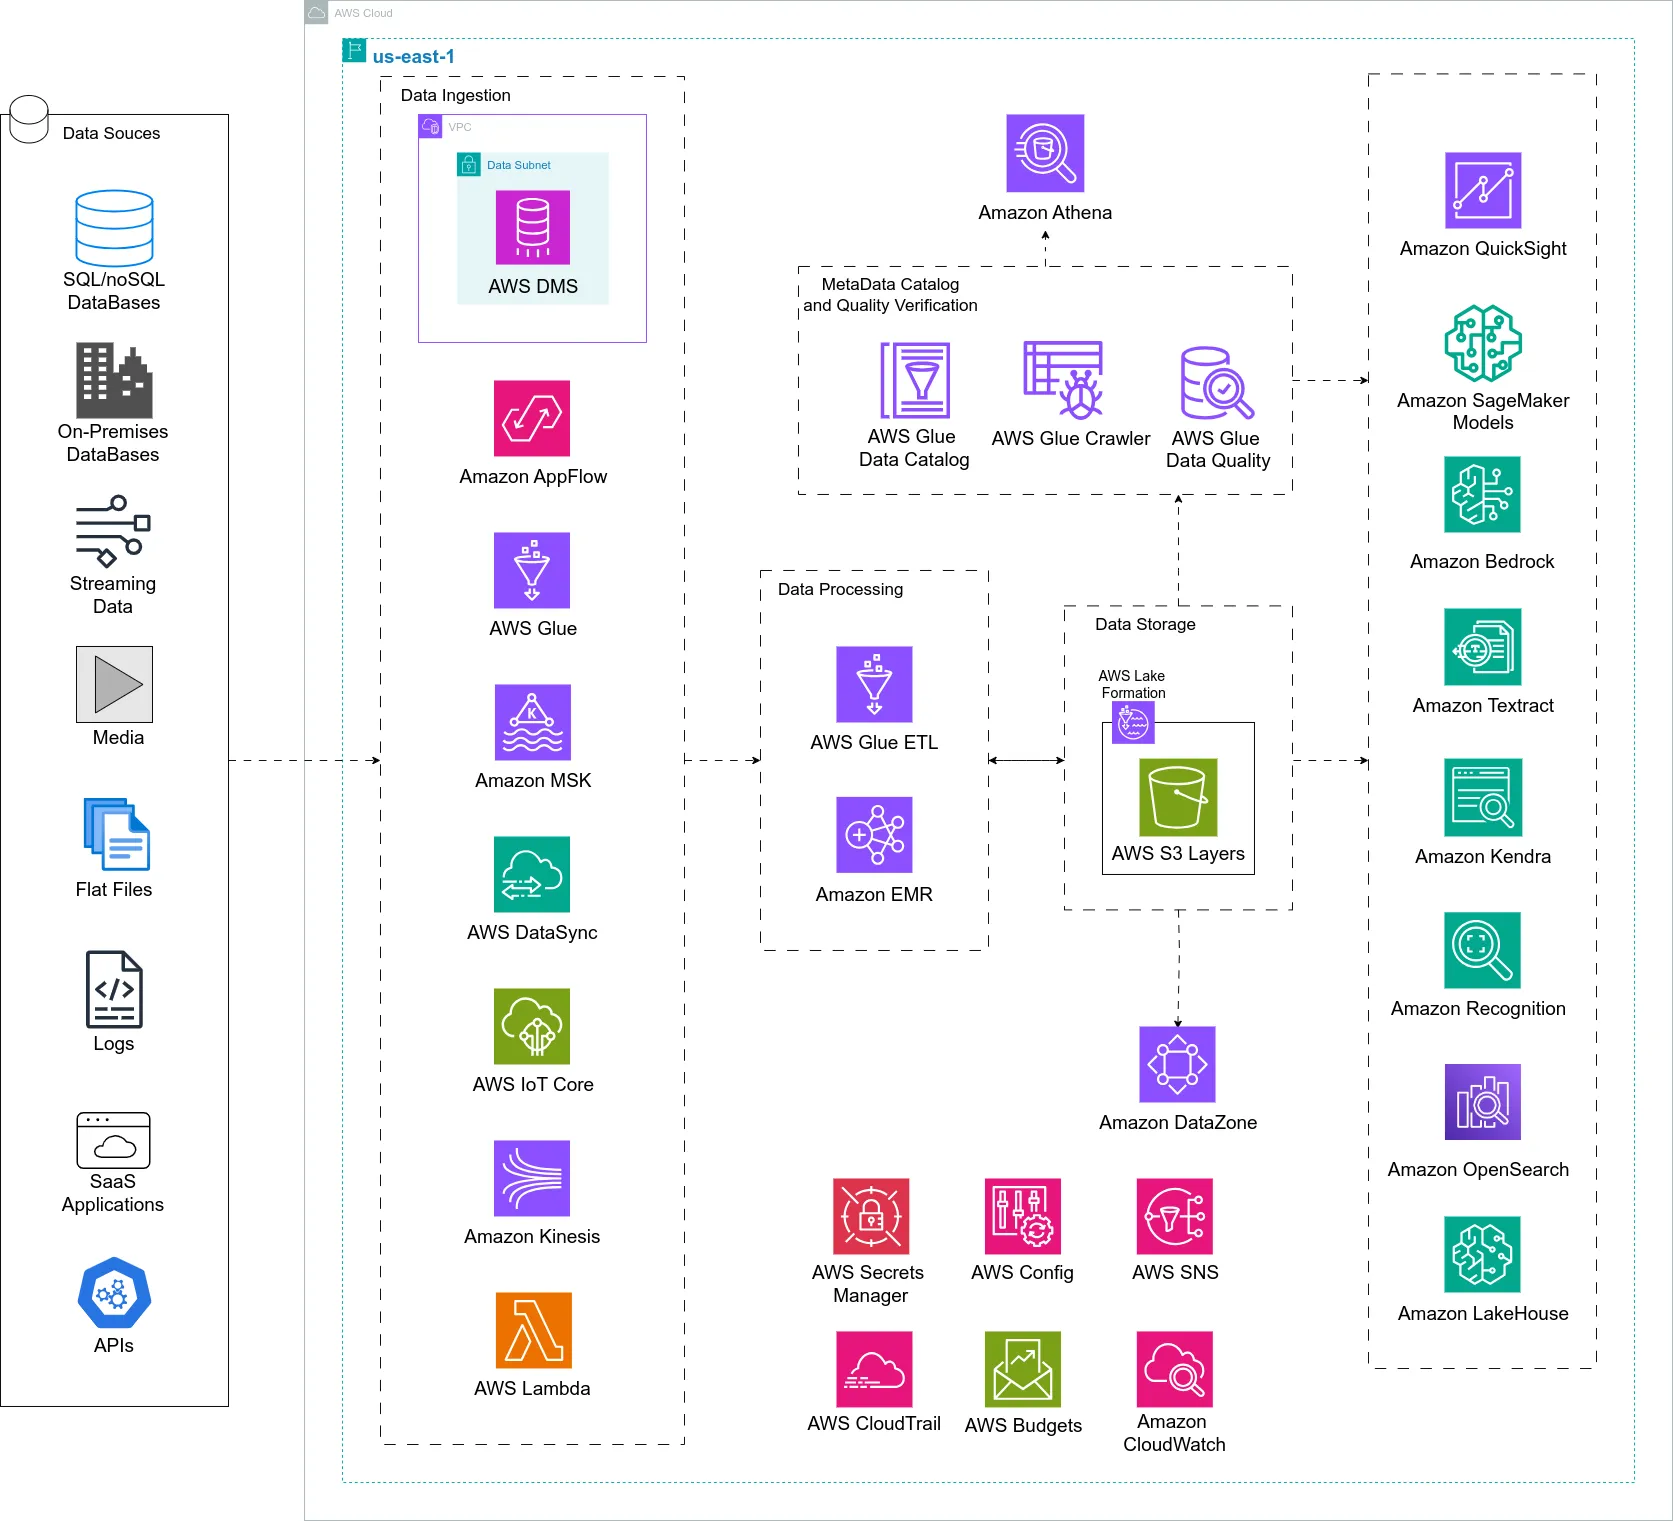
- AWS Lake Formation para Governança Centralizada: Permite a gestão eficiente e segura do Data Lake, com controle de acesso granular, monitoramento de atividades e conformidade com regulamentações, garantindo um ambiente confiável para armazenamento e análise de dados.
- Amazon S3 com Estrutura em Camadas: O armazenamento escalável e seguro do Amazon S3 é organizado nas camadas Bronze, Silver e Gold, permitindo a ingestão de dados brutos, transformações intermediárias e otimizações para análises estratégicas. Essa estrutura promove eficiência operacional e acessibilidade para diversas equipes.
- AWS Glue para Pipelines ETL: Fornece transformações avançadas e automação de processos ETL, garantindo que os dados estejam preparados para análises em tempo real e relatórios estratégicos. A solução inclui particionamento e compactação para maximizar a performance.
- Amazon Athena para Consultas Escaláveis: Oferece consultas rápidas e confiáveis diretamente no Data Lake, permitindo análises ad hoc e suporte a decisões críticas, tudo sem necessidade de provisionar infraestrutura adicional.
- AWS Step Functions e Amazon EventBridge para Orquestração Automatizada: Automatizam o fluxo de processamento de dados, assegurando que as diferentes etapas do pipeline sejam executadas de maneira confiável, escalável e monitorada.
- AWS DMS para Ingestão de Dados: Garante a transferência segura e eficiente de dados de bancos de dados locais ou de outras nuvens para o Data Lake na AWS, utilizando VPN Site-to-Site para maior segurança e confiabilidade.
- Glue Data Catalog para Descoberta de Dados: Centraliza e organiza os metadados do Data Lake, facilitando a descoberta, classificação e uso dos dados por diferentes ferramentas e equipes, promovendo a reutilização e o controle eficiente.
- AWS Secrets Manager para Gerenciamento Seguro de Credenciais: Simplifica o gerenciamento e a proteção de credenciais e segredos necessários para integração com sistemas externos e fontes de dados, garantindo conformidade e segurança nas conexões.
- Amazon EMR para Processamento Avançado de Dados: O Amazon EMR permite executar frameworks de Big Data, como Apache Spark, Hadoop e Presto, diretamente nos dados armazenados no Data Lake. Ele é ideal para análises complexas, aprendizado de máquina e cargas de trabalho distribuídas, com escalabilidade automática para gerenciar clusters de grande porte de forma eficiente.
- Machine Learning e Integração com Amazon SageMaker: O Data Lake organizado em camadas (Bronze, Silver e Gold) fornece uma base robusta para o treinamento de modelos de aprendizado de máquina no Amazon SageMaker. A integração nativa com serviços como AWS Glue DataBrew facilita a preparação de dados para análises preditivas e prescritivas, enquanto o Amazon Forecast e o Amazon Comprehend podem ser usados para criar insights preditivos e análises de texto avançadas.
Arquitetura
Para esta solução, fornecemos arquiteturas especializadas ao caso, oferecendo alternativas para implementações típicas de Data Lake com níveis variados de escalabilidade, eficiência de custo e automação de processos. Cada arquitetura é projetada para abordar casos de uso específicos, incluindo ingestão de dados via APIs, integração com bancos de dados externos, cenários altamente complexos com governança avançada e fluxo de dados em tempo real.
Casos de Uso
- Data Lakes para Processamento de Alto Volume: Perfeito para empresas que gerenciam grandes volumes de dados, como bancos, seguradoras ou indústrias com múltiplas fontes de dados.
- Análises para Decisões Estratégicas: Ideal para organizações que necessitam de dados otimizados e prontos para análises rápidas, como empresas de BI ou departamentos de marketing que utilizam machine learning para prever tendências.
- Armazenamento e Processamento de Dados Complexos: Ótimo para cenários que exigem o processamento de dados heterogêneos e não estruturados, como logs de sistemas, arquivos de mídia ou grandes datasets usados em pesquisas científicas.
- Armazenamento e Processamento de Dados em Tempo Real: Ótimo para cenários onde é necessário a captação, o processamento e o armazenamento de dados em tempo real, como clickstream, video stream, log stream dentre outros.
- Conformidade e Segurança de Dados: Essencial para organizações que precisam cumprir regulamentações rigorosas, como LGPD, GDPR ou HIPAA, garantindo a proteção de dados sensíveis e a implementação de controles de acesso robustos. Ideal para setores como saúde, finanças e governo, onde a governança e a auditoria de dados são cruciais.
- Machine Learning e Inteligência Artificial: Fundamental para empresas que desejam explorar análises preditivas e prescritivas, utilizando dados organizados no Data Lake para treinamento de modelos de aprendizado de máquina. O Data Lake serve como base para soluções de IA em áreas como personalização de conteúdo, previsão de demanda e análise de sentimento. Com integração a serviços como Amazon SageMaker, é possível desenvolver e implantar modelos diretamente nos dados armazenados.