Data Lake con AWS: Gobernanza, Escalabilidad e Insights en la Nube
CloudDog presenta una solución de Data Lake de alta eficiencia, aprovechando los potentes servicios de la Nube AWS para optimizar la organización y el análisis de datos. Nuestra arquitectura incluye AWS Lake Formation para una gestión centralizada y segura del catálogo de datos, garantizando gobernanza robusta y descubrimiento simplificado. Usamos S3 para almacenar, Glue para ETL, Athena para consultas y Step Functions con EventBridge para automatización.
Características
- AWS Lake Formation para Gobernanza Centralizada: Permite la gestión eficiente y segura del Data Lake, con control de acceso granular, monitoreo de actividades y cumplimiento de regulaciones, garantizando un ambiente confiable para el almacenamiento y análisis de datos.
- Amazon S3 con Estructura en Capas: El almacenamiento escalable y seguro de Amazon S3 se organiza en las capas Bronze, Silver y Gold, permitiendo la ingesta de datos brutos, transformaciones intermedias y optimizaciones para análisis estratégicos. Esta estructura promueve la eficiencia operacional y la accesibilidad para diversos equipos.
- AWS Glue para Pipelines ETL: Ofrece transformaciones avanzadas y automatización de procesos ETL, garantizando que los datos estén preparados para análisis en tiempo real e informes estratégicos. La solución incluye particionamiento y compactación para maximizar el rendimiento.
- Amazon Athena para Consultas Escalables: Ofrece consultas rápidas y confiables directamente en el Data Lake, permitiendo análisis ad hoc y soporte a decisiones críticas, todo sin necesidad de provisionar infraestructura adicional.
- AWS Step Functions y Amazon EventBridge para Orquestación Automatizada: Automatizan el flujo de procesamiento de datos, asegurando que las diferentes etapas del pipeline se ejecuten de manera confiable, escalable y monitoreada.
- AWS DMS para Ingesta de Datos: Garantiza la transferencia segura y eficiente de datos desde bases de datos locales o de otras nubes hacia el Data Lake en AWS, utilizando VPN Site-to-Site para mayor seguridad y confiabilidad.
- Glue Data Catalog para Descubrimiento de Datos: Centraliza y organiza los metadatos del Data Lake, facilitando el descubrimiento, la clasificación y el uso de los datos por diferentes herramientas y equipos, promoviendo la reutilización y el control eficiente.
- AWS Secrets Manager para Gestión Segura de Credenciales: Simplifica la gestión y la protección de credenciales y secretos necesarios para la integración con sistemas externos y fuentes de datos, garantizando cumplimiento y seguridad en las conexiones.
- Amazon EMR para Procesamiento Avanzado de Datos: Amazon EMR permite ejecutar frameworks de Big Data, como Apache Spark, Hadoop y Presto, directamente sobre los datos almacenados en el Data Lake. Es ideal para análisis complejos, aprendizaje automático y cargas de trabajo distribuidas, con escalabilidad automática para gestionar clusters de gran tamaño de forma eficiente.
- Machine Learning e Integración con Amazon SageMaker: El Data Lake organizado en capas (Bronze, Silver y Gold) ofrece una base robusta para el entrenamiento de modelos de aprendizaje automático en Amazon SageMaker. La integración nativa con servicios como AWS Glue DataBrew facilita la preparación de datos para análisis predictivos y prescriptivos, mientras que Amazon Forecast y Amazon Comprehend pueden usarse para crear insights predictivos y análisis de texto avanzados.
Arquitectura
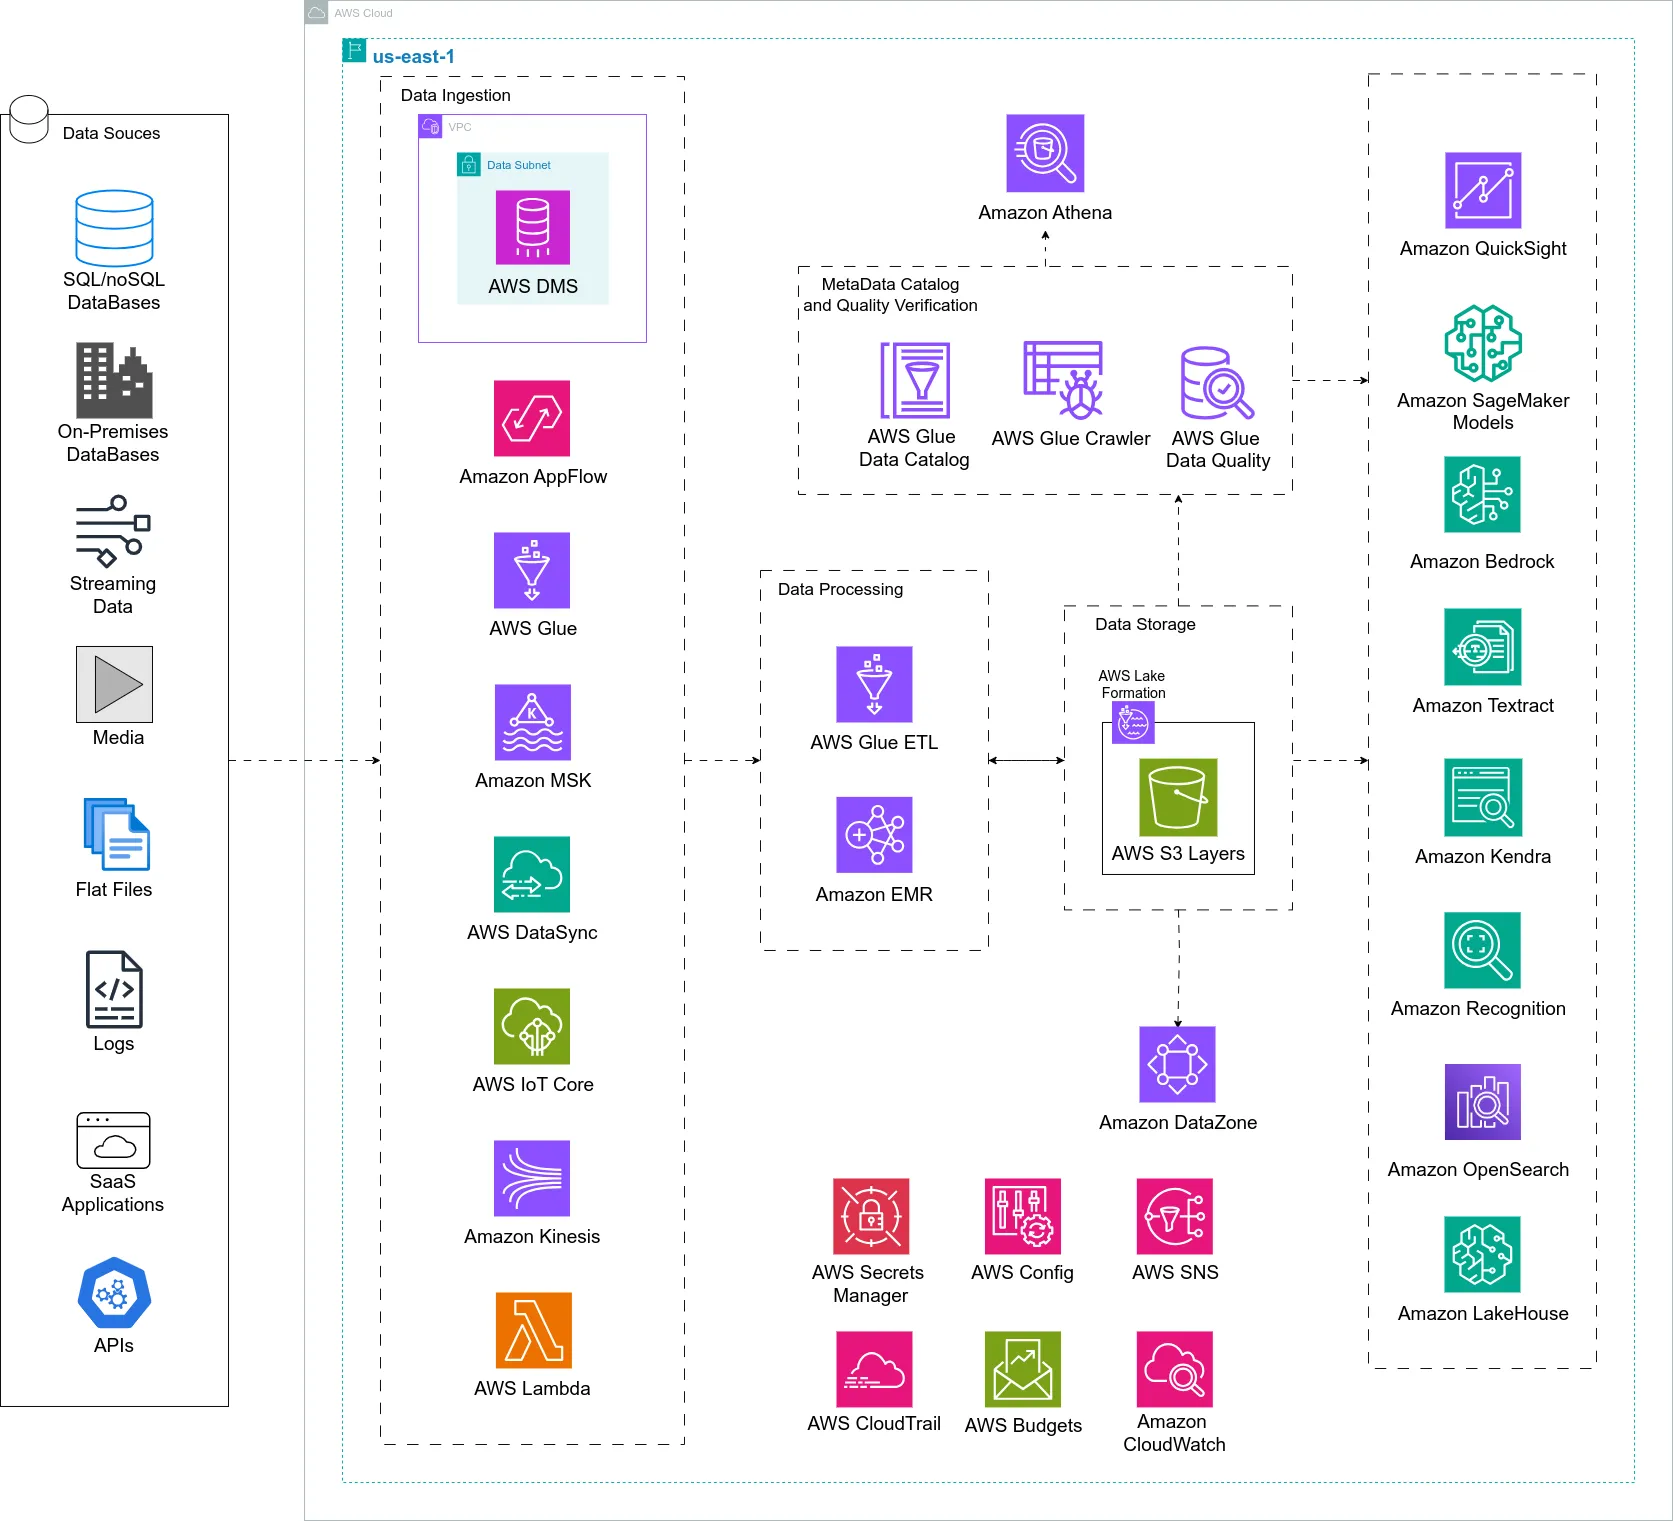
Para esta solución, ofrecemos arquitecturas especializadas para cada caso, brindando alternativas para implementaciones típicas de Data Lake con niveles variados de escalabilidad, eficiencia de costos y automatización de procesos. Cada arquitectura está diseñada para abordar casos de uso específicos, incluyendo la ingesta de datos vía APIs, la integración con bases de datos externas, escenarios altamente complejos con gobernanza avanzada y flujo de datos en tiempo real.
Casos de Uso
- Data Lakes para Procesamiento de Alto Volumen: Perfecto para empresas que gestionan grandes volúmenes de datos, como bancos, aseguradoras o industrias con múltiples fuentes de datos.
- Análisis para Decisiones Estratégicas: Ideal para organizaciones que necesitan datos optimizados y listos para análisis rápidos, como empresas de BI o departamentos de marketing que utilizan machine learning para prever tendencias.
- Almacenamiento y Procesamiento de Datos Complejos: Excelente para escenarios que exigen el procesamiento de datos heterogéneos y no estructurados, como logs de sistemas, archivos de medios o grandes datasets usados en investigaciones científicas.
- Almacenamiento y Procesamiento de Datos en Tiempo Real: Excelente para escenarios donde es necesaria la captación, el procesamiento y el almacenamiento de datos en tiempo real, como clickstream, video stream, log stream, entre otros.
- Cumplimiento y Seguridad de Datos: Esencial para organizaciones que deben cumplir regulaciones rigurosas, como LGPD, GDPR o HIPAA, garantizando la protección de datos sensibles y la implementación de controles de acceso robustos. Ideal para sectores como salud, finanzas y gobierno, donde la gobernanza y la auditoría de datos son cruciales.
- Machine Learning e Inteligencia Artificial: Fundamental para empresas que desean explorar análisis predictivos y prescriptivos, utilizando datos organizados en el Data Lake para el entrenamiento de modelos de aprendizaje automático. El Data Lake sirve como base para soluciones de IA en áreas como personalización de contenido, previsión de demanda y análisis de sentimiento. Con la integración con servicios como Amazon SageMaker, es posible desarrollar e implementar modelos directamente sobre los datos almacenados.