
En un mundo cada vez más digital, las videollamadas se vuelven lo normal en el día a día. Sin embargo, extraer información importante de esas reuniones puede ser una tarea tediosa, que muchas veces obliga a revisar grabaciones o a tomar notas durante la reunión. Aun así, registrar los puntos clave discutidos y los próximos pasos definidos es crucial para la continuidad de los proyectos y la eficiencia organizacional, lo que la convierte en una etapa obligatoria.
Con el avance de las tecnologías de IA, específicamente de los Grandes Modelos de Lenguaje (LLM) como GPT-4, surgieron nuevas posibilidades en el tratamiento y la extracción de información en datos no estructurados. Estas herramientas permiten la creación de soluciones innovadoras para problemas complejos, donde los métodos y tecnologías convencionales no consiguen ser efectivos.
Ante este escenario, las innovaciones traídas por los Grandes Modelos de Lenguaje se presentan como herramientas valiosas. Permiten la transformación de datos no estructurados generados en videollamadas en insights accionables y registros organizados, pavimentando así el camino para una gestión de información más eficaz y automatizada.
Introducción a la Solución
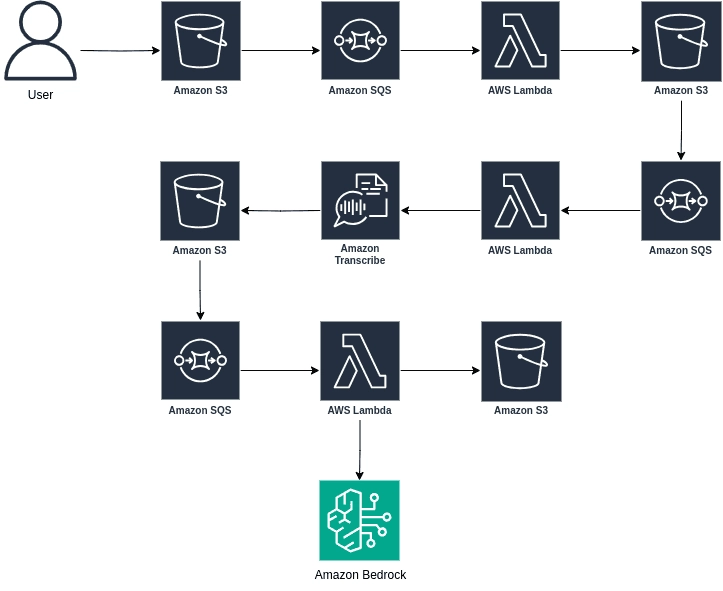
La propuesta de solución para el problema utiliza una arquitectura serverless con los servicios de AWS. La solución sigue el siguiente flujo:
Al subir un video a Amazon S3, una Lambda es activada por el Event Notification del Bucket.
La función extrae el audio del video y guarda el archivo en otra carpeta del Bucket.
Este archivo dispara un Event Notification para otra Lambda.
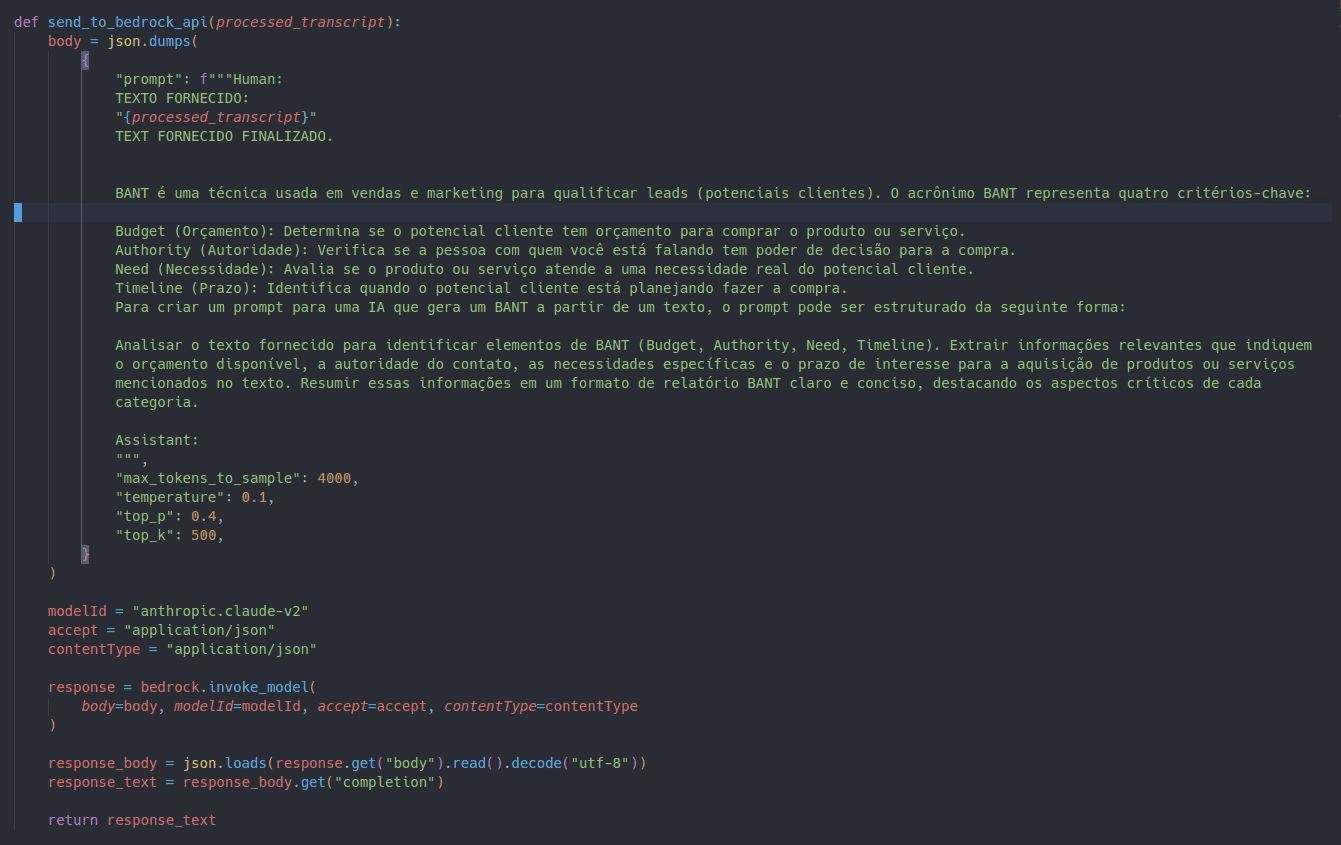
La Lambda crea un job en Amazon Transcribe.
El resultado del job se envía al Bucket.
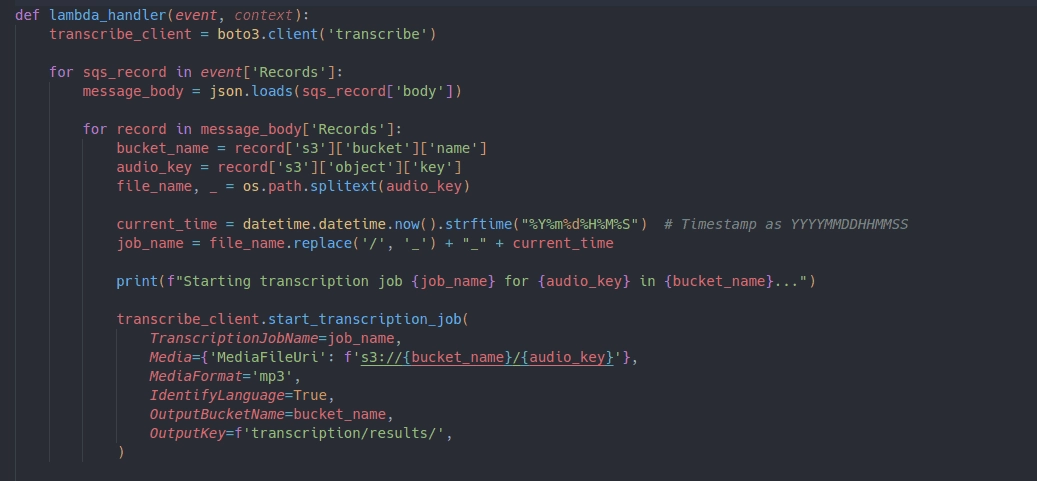
Una Lambda es disparada por el resultado del job, aplica algunos tratamientos y envía el texto con un prompt a la API de Amazon Bedrock; el prompt está escrito con el objetivo de extraer los principales puntos discutidos en la reunión y, si los hay, cuáles fueron los próximos pasos definidos.
Extracción del Audio
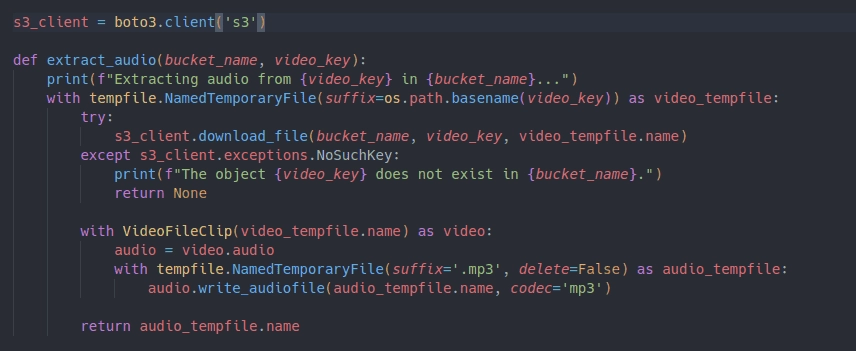
El primer paso para automatizar la extracción de la información de una videollamada es obtener el audio del video. Este proceso se inicia con un Event Notification, de modo que, al cargar un video en el Bucket S3, se dispara una función Lambda.
Entonces la función Lambda hace uso de una biblioteca de python para extraer el audio del video. Una vez extraído, el audio se almacena en el mismo Bucket S3, pero en una carpeta diferente, con el fin de mantener una organización clara de los datos.
Este nuevo archivo de audio activa la siguiente etapa del proceso: la ejecución de un job en Amazon Transcribe. Es aquí donde el audio será transcrito a texto, posibilitando la extracción y el análisis de la información de una videollamada por un LLM.
Ejecutar un Job en Transcribe
Amazon Transcribe es una herramienta poderosa de conversión de voz a texto, diseñada para simplificar el proceso de transcripción de audio. Este servicio utiliza el concepto de jobs, que son configuraciones específicas para procesar los archivos de audio deseados.
Al crear un job en Amazon Transcribe, el usuario necesita proporcionar información esencial, como la ubicación del archivo de audio, el idioma hablado en el audio y, si es necesario, también puede utilizar un vocabulario personalizado para garantizar la precisión de la transcripción, especialmente en casos que involucran términos técnicos o jergas específicas.
El proceso de transcripción propiamente dicho se inicia cuando el job es activado. En ese momento, el archivo de audio se somete al sistema, que utiliza algoritmos avanzados de reconocimiento de voz para convertir el habla en texto. Al finalizar el job, el resultado es un archivo en formato JSON que contiene no solo la transcripción textual, sino también información adicional como la confianza en la precisión de la transcripción (indicando cuán confiable es el texto transcrito) y la marca de tiempo de cada palabra.
Tras la conclusión del proceso de transcripción, el siguiente paso es la utilización de Amazon Bedrock. Amazon Bedrock desempeña un papel esencial en la continuación del proceso. Una vez que el texto ha sido transcrito, es hora de extraer insights y realizar análisis más profundos.
Utilización de Amazon Bedrock
Con el texto transcrito por Amazon Transcribe en mano, el flujo continúa con un nuevo Event Notification que activa una Lambda, que realiza una llamada a la API de Amazon Bedrock. Este servicio gestionado de AWS facilita la creación y el escalado de aplicaciones de IA generativa utilizando modelos de base. Ofrece diversas opciones de modelos de varias organizaciones líderes de IA, permitiendo actualizaciones con pocos cambios de código.
Amazon Bedrock permite la personalización fácil de modelos con datos propios sin necesidad de programación. Puede construir agentes gestionados que invocan APIs para realizar tareas complejas; también posee soporte nativo para Generación Aumentada por Recuperación (RAG) para conectar modelos a bases de datos propietarias, garantizando la seguridad de los datos y la conformidad con normas como HIPAA y GDPR.
El modelo elegido para la solución es Claude 2.0, que es un modelo de lenguaje de gran escala, con una impresionante ventana de contexto de 100K tokens, lo que permite un análisis detallado de grandes bloques de texto. Su habilidad para procesar y entender contextos complejos lo convierte en una herramienta valiosa en la extracción de información crítica a partir del texto transcrito.
En el core de Bedrock, Claude 2.0 se activa con un prompt predefinido, que orienta al modelo sobre qué buscar en el texto transcrito. Este prompt puede configurarse para identificar y extraer los puntos clave discutidos y las acciones futuras definidas durante la reunión, proporcionando una visión clara y concisa del contenido discutido.
Los Modelos de Lenguaje de Gran Escala (LLM) como Claude 2.0 son conocidos por su versatilidad y capacidad de adaptarse a una variedad de tareas de procesamiento de lenguaje natural. Esta flexibilidad convierte a Amazon Bedrock en una plataforma robusta y adaptable para lidiar con los desafíos de análisis de texto, posibilitando transformar transcripciones de reuniones en insights accionables de forma eficaz y eficiente.
Al utilizar Amazon Bedrock, las organizaciones no solo consiguen automatizar la extracción de información de reuniones, sino que también amplían sus capacidades de análisis de texto, permitiendo un análisis más profundo y contextualizado de datos no estructurados.
Conclusión
La solución propuesta ofrece un sistema totalmente serverless que alivia un dolor de negocio significativo, automatizando la extracción de información de reuniones grabadas. Además, se integra armoniosamente con los servicios de AWS, proporcionando una implementación simplificada y una operación eficiente. Al aprovechar el poder de Amazon Bedrock y de los Modelos de Lenguaje de Gran Escala, las organizaciones pueden ahora transformar sus videoconferencias en insights accionables, impulsando así la productividad y la toma de decisiones informada.
