
Antes de Mapear Qualquer Coisa, uma Pergunta Simples
Toda empresa que decide montar um Data Lake chega num ponto em que a arquitetura já parece decidida, mas a pergunta “por onde começar” ainda não tem resposta. É comum um time técnico sair direto para escolher ferramentas (qual serviço de armazenamento, qual catálogo, qual motor de consulta) antes de responder uma pergunta mais simples: quais dados a empresa já tem, onde eles estão hoje, e quem precisa consultar cada um.
Esse caminho ao contrário custa caro. Um Data Lake desenhado sem esse diagnóstico inicial tende a crescer cheio de dados que ninguém sabe de onde vieram, sem controle de quem pode ler o quê, e sem nenhuma consulta rodando de verdade depois de meses de trabalho. O caminho que funciona é o oposto: diagnosticar primeiro, desenhar a arquitetura depois, e só então colocar a mão na implementação.
O Caminho do Diagnóstico à Primeira Consulta
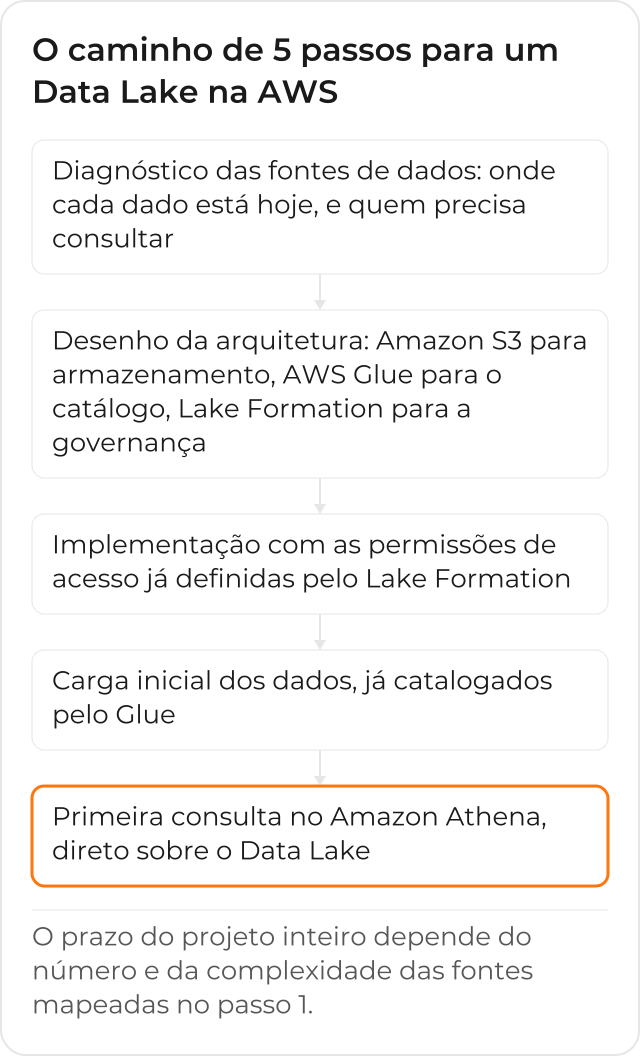
Os 5 passos abaixo seguem essa ordem de propósito: cada um prepara o terreno para o seguinte, e pular um deles costuma significar voltar atrás mais tarde para refazer o que ficou faltando.
Passo 1: Diagnóstico das Fontes de Dados Atuais
Antes de desenhar qualquer arquitetura, é preciso mapear onde os dados da empresa estão hoje: CRM, ERP, planilhas de controle, logs de aplicação, sistemas legados que ainda guardam parte da operação. Para cada fonte, o diagnóstico também registra o quanto ela já está estruturada (um banco relacional, por exemplo) ou não (um conjunto de arquivos de log em texto puro), porque essa diferença muda o que o próximo passo vai desenhar.
Esse diagnóstico não é um levantamento técnico isolado: ele também pergunta quem, no time de negócio, precisa consultar cada uma dessas fontes, e com que frequência. Sem essa resposta, a arquitetura seguinte corre o risco de ser tecnicamente correta e, ainda assim, não responder à pergunta que motivou o projeto desde o início.
Passo 2: Desenho da Arquitetura na AWS
Com as fontes mapeadas, a arquitetura do Data Lake é desenhada em torno de 3 peças que trabalham juntas.
O Papel do Amazon S3, do AWS Glue e do Lake Formation
O Amazon S3 é a camada de armazenamento: recebe o dado bruto, em qualquer formato, sem exigir que a estrutura seja definida antes de guardar nada. O AWS Glue é o serviço serverless que descobre, cataloga e prepara esse dado: os crawlers do Glue inferem o esquema automaticamente e registram essa informação num catálogo central, que é o que permite consultar o dado mais tarde sem precisar lembrar manualmente onde cada arquivo está. E o AWS Lake Formation centraliza o controle de acesso: quem pode ler o quê, com permissões detalhadas por coluna, linha ou célula, aplicadas de forma consistente em serviços de análise como o Amazon Athena, o Amazon Redshift Spectrum e o Amazon EMR, entre outros, sem precisar repetir essa configuração em cada ferramenta separadamente.
Passo 3: Implementação com Governança Desde o Início
A implementação do Data Lake já nasce com essas permissões definidas pelo Lake Formation, em vez de abrir o armazenamento primeiro e organizar o acesso depois. Essa ordem importa: corrigir o controle de acesso depois que o dado já está espalhado e sendo consultado por várias áreas é um trabalho muito maior do que definir as permissões antes da primeira carga.
Passo 4: Carga Inicial e Catalogação dos Dados
As fontes mapeadas no primeiro passo são conectadas e carregadas no Data Lake, já passando pelo catálogo do Glue para ficarem localizáveis nas consultas seguintes. É nesse momento que a diferença entre uma fonte estruturada e uma não estruturada aparece na prática: o Glue consegue inferir o esquema de muitas fontes automaticamente, mas alguns formatos exigem uma preparação adicional antes de ficarem prontos para consulta.
Passo 5: a Primeira Consulta no Amazon Athena
Com os dados carregados e catalogados, o Amazon
Athena permite consultar o
Data Lake diretamente, sem mover os dados para nenhum outro lugar. O trecho abaixo segue o formato
de uma CREATE EXTERNAL TABLE da documentação oficial do Athena, apontando para um arquivo de log
de vendas guardado no S3:
CREATE EXTERNAL TABLE vendas_diarias (
  data_venda string,
  produto string,
  quantidade int,
  valor_total double
  )
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION 's3://clouddog-data-lake-exemplo/vendas/'
Cada instrução roda separada, uma por vez, no editor de consultas do Athena: depois que a tabela existe, a primeira consulta de negócio já pode rodar sobre ela.
SELECT produto, SUM(valor_total) AS total
FROM vendas_diarias
GROUP BY produto
ORDER BY total DESC
Essa é a primeira consulta que de fato devolve uma resposta de negócio (quais produtos venderam mais, por exemplo), em vez de só confirmar que os dados chegaram no lugar certo. É também, normalmente, o primeiro momento em que o time de negócio vê um resultado tangível do projeto.
Quanto Tempo Esse Caminho Costuma Levar
O primeiro painel com dados do Data Lake costuma ficar pronto nas primeiras semanas depois da carga inicial; o prazo do projeto inteiro, do diagnóstico à primeira consulta recorrente, depende diretamente do número e da complexidade das fontes mapeadas no passo 1. Um diagnóstico malfeito no início tende a esticar justamente os passos finais, porque problemas de qualidade de dado que deveriam ter sido identificados no passo 1 acabam aparecendo só na hora de consultar.
Erros Comuns ao Pular um dos Passos
Pular o diagnóstico do passo 1 é o erro mais caro dos 5: sem saber quais fontes existem e quem precisa consultar cada uma, a arquitetura do passo 2 acaba sendo desenhada para um uso genérico de “guardar todo dado”, em vez de para as perguntas de negócio que o time de verdade precisa responder. O resultado típico é um Data Lake tecnicamente correto que ninguém consulta, porque nenhuma das perguntas originais foi levada em conta no desenho.
Pular a governança do passo 3, e deixar o controle de acesso para depois, custa de um jeito diferente: o dado já está espalhado e sendo consultado por várias áreas quando alguém lembra de definir quem pode ler o quê. Nesse ponto, restringir o acesso significa negociar com times que já construíram relatórios e processos em cima do acesso aberto, em vez de simplesmente configurar uma permissão antes de alguém depender dela.
E pular a catalogação do passo 4, carregando dados sem registrar o esquema no Glue, transforma o Data Lake numa pilha de arquivos sem mapa: cada consulta nova exige redescobrir manualmente onde cada dado está e qual é o formato dele, exatamente o trabalho que o catálogo deveria ter eliminado desde a primeira carga.
Como Fica o Dia a Dia do Seu Time Depois do Primeiro Data Lake
Depois que o primeiro Data Lake está no ar, com governança desde o início e o catálogo do Glue mantendo tudo localizável, a pergunta que o time de negócio faz deixa de ser “onde está esse dado” e passa a ser a pergunta de negócio propriamente dita. Novas fontes entram no mesmo caminho dos 5 passos, em vez de abrir uma exceção cada vez que alguém precisa de um dado novo; e o controle de acesso definido desde o passo 3 continua valendo, sem precisar ser refeito a cada fonte nova.
A CloudDog conduz esse processo, do diagnóstico das fontes à primeira consulta recorrente, na página de Consultoria de Dados e Data Lake com AWS.
