
Antes de Mapear Cualquier Cosa, una Pregunta Simple
Toda empresa que decide montar un Data Lake llega a un punto en que la arquitectura parece ya decidida, pero la pregunta “por dónde empezar” todavía no tiene respuesta. Es común que un equipo técnico pase directo a elegir herramientas (qué servicio de almacenamiento, qué catálogo, qué motor de consulta) antes de responder una pregunta más simple: qué datos la empresa ya tiene, dónde están hoy, y quién necesita consultar cada uno.
Ese camino al revés sale caro. Un Data Lake diseñado sin ese diagnóstico inicial tiende a crecer lleno de datos que nadie sabe de dónde vinieron, sin control de quién puede leer qué, y sin ninguna consulta corriendo de verdad después de meses de trabajo. El camino que funciona es el contrario: diagnosticar primero, diseñar la arquitectura después, y solo entonces poner manos a la implementación.
El Camino del Diagnóstico a la Primera Consulta
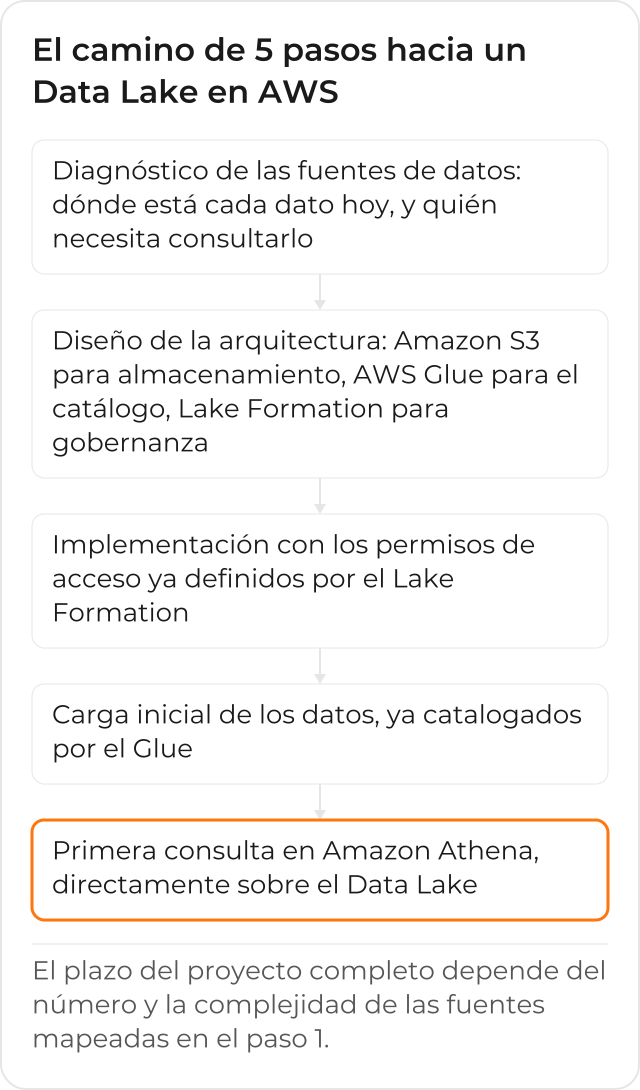
Los 5 pasos de abajo siguen ese orden a propósito: cada uno prepara el terreno para el siguiente, y saltarse uno suele significar volver atrás más tarde para rehacer lo que quedó faltando.
Paso 1: Diagnóstico de las Fuentes de Datos Actuales
Antes de diseñar cualquier arquitectura, hay que mapear dónde están los datos de la empresa hoy: CRM, ERP, hojas de cálculo de control, logs de aplicación, sistemas heredados que todavía guardan parte de la operación. Para cada fuente, el diagnóstico también registra cuánto ya está estructurada (una base relacional, por ejemplo) o no (un conjunto de archivos de log en texto plano), porque esa diferencia cambia lo que el siguiente paso va a diseñar.
Ese diagnóstico no es un levantamiento técnico aislado: también pregunta quién, en el lado de negocio, necesita consultar cada una de esas fuentes, y con qué frecuencia. Sin esa respuesta, la arquitectura siguiente corre el riesgo de ser técnicamente correcta y, aun así, no responder la pregunta que motivó el proyecto desde el principio.
Paso 2: Diseño de la Arquitectura en AWS
Con las fuentes mapeadas, la arquitectura del Data Lake se diseña alrededor de 3 piezas que trabajan juntas.
El Papel del Amazon S3, del AWS Glue y del Lake Formation
El Amazon S3 es la capa de almacenamiento: recibe el dato bruto, en cualquier formato, sin exigir que la estructura se defina antes de guardar nada. El AWS Glue es el servicio serverless que descubre, cataloga y prepara ese dato: los crawlers del Glue infieren el esquema automáticamente y registran esa información en un catálogo central, que es lo que permite consultar el dato más adelante sin tener que recordar manualmente dónde está cada archivo. Y el AWS Lake Formation centraliza el control de acceso: quién puede leer qué, con permisos detallados por columna, fila o celda, aplicados de forma consistente en servicios de análisis como el Amazon Athena, el Amazon Redshift Spectrum y el Amazon EMR, entre otros, sin tener que repetir esa configuración en cada herramienta por separado.
Paso 3: Implementación con Gobernanza Desde el Inicio
La implementación del Data Lake ya nace con esos permisos definidos por el Lake Formation, en vez de abrir el almacenamiento primero y organizar el acceso después. Ese orden importa: corregir el control de acceso después de que el dato ya está repartido y siendo consultado por varias áreas es un trabajo mucho mayor que definir los permisos antes de la primera carga.
Paso 4: Carga Inicial y Catalogación de los Datos
Las fuentes mapeadas en el primer paso se conectan y se cargan en el Data Lake, ya pasando por el catálogo del Glue para quedar localizables en las consultas siguientes. Es en ese momento que la diferencia entre una fuente estructurada y una no estructurada aparece en la práctica: el Glue consigue inferir el esquema de muchas fuentes automáticamente, pero algunos formatos exigen una preparación adicional antes de quedar listos para consulta.
Paso 5: la Primera Consulta en Amazon Athena
Con los datos cargados y catalogados, el Amazon
Athena permite consultar el
Data Lake directamente, sin mover los datos a ningún otro lugar. El fragmento de abajo sigue el
formato de un CREATE EXTERNAL TABLE de la documentación oficial del Athena, apuntando a un
archivo de log de ventas guardado en el S3:
CREATE EXTERNAL TABLE ventas_diarias (
  fecha_venta string,
  producto string,
  cantidad int,
  valor_total double
  )
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION 's3://clouddog-data-lake-ejemplo/ventas/'
Cada instrucción corre por separado, una a la vez, en el editor de consultas del Athena: una vez que la tabla existe, la primera consulta de negocio ya puede correr sobre ella.
SELECT producto, SUM(valor_total) AS total
FROM ventas_diarias
GROUP BY producto
ORDER BY total DESC
Esa es la primera consulta que de verdad devuelve una respuesta de negocio (qué productos vendieron más, por ejemplo), en vez de solo confirmar que los datos llegaron al lugar correcto. También es, normalmente, el primer momento en que el lado de negocio ve un resultado tangible del proyecto.
Cuánto Tiempo Suele Llevar Este Camino
El primer panel con datos del Data Lake suele quedar listo en las primeras semanas después de la carga inicial; el plazo del proyecto completo, del diagnóstico a la primera consulta recurrente, depende directamente del número y la complejidad de las fuentes mapeadas en el paso 1. Un diagnóstico mal hecho al principio tiende a estirar justamente los pasos finales, porque problemas de calidad de dato que deberían haberse identificado en el paso 1 terminan apareciendo solo a la hora de consultar.
Errores Comunes al Saltarse uno de los Pasos
Saltarse el diagnóstico del paso 1 es el error más caro de los 5: sin saber qué fuentes existen y quién necesita consultar cada una, la arquitectura del paso 2 termina diseñada para un uso genérico de “guardar todo el dato”, en vez de para las preguntas de negocio que el equipo realmente necesita responder. El resultado típico es un Data Lake técnicamente correcto que nadie consulta, porque ninguna de las preguntas originales se tuvo en cuenta en el diseño.
Saltarse la gobernanza del paso 3, y dejar el control de acceso para después, cuesta de una forma distinta: el dato ya está repartido y siendo consultado por varias áreas cuando alguien se acuerda de definir quién puede leer qué. En ese punto, restringir el acceso significa negociar con equipos que ya construyeron reportes y procesos sobre el acceso abierto, en vez de simplemente configurar un permiso antes de que alguien dependa de él.
Y saltarse la catalogación del paso 4, cargando datos sin registrar el esquema en el Glue, convierte el Data Lake en una pila de archivos sin mapa: cada consulta nueva exige redescubrir manualmente dónde está cada dato y cuál es su formato, exactamente el trabajo que el catálogo debería haber eliminado desde la primera carga.
Cómo Queda el Día a Día de Su Equipo Después del Primer Data Lake
Después de que el primer Data Lake está en el aire, con gobernanza desde el inicio y el catálogo del Glue manteniendo todo localizable, la pregunta que hace el lado de negocio deja de ser “dónde está ese dato” y pasa a ser la pregunta de negocio propiamente dicha. Las fuentes nuevas entran por el mismo camino de 5 pasos, en vez de abrir una excepción cada vez que alguien necesita un dato nuevo; y el control de acceso definido desde el paso 3 sigue valiendo, sin necesidad de rehacerse en cada fuente nueva.
CloudDog conduce este proceso, del diagnóstico de las fuentes a la primera consulta recurrente, en la página de Consultoría de Datos y Data Lake con AWS.
