
O Seu Time Já Tem o Dado, mas Ainda Não Decidiu Onde Guardar Ele
Toda empresa que começa a organizar os próprios dados chega numa pergunta parecida: o dado bruto, cru, de todo lugar, ou o dado já arrumado, prontinho para a pergunta que o time de negócio faz todo mês? A resposta não é “um é melhor que o outro”: é entender qual pergunta a sua empresa precisa responder primeiro, e aí escolher a peça certa para aquele momento.
É comum um time técnico escolher a arquitetura antes de saber qual pergunta ela vai responder, porque Data Lake e Data Warehouse são termos que aparecem o tempo todo em qualquer conversa sobre dados. O problema de escolher assim é construir uma estrutura cara e sofisticada para uma pergunta simples, ou o contrário: tentar responder uma pergunta analítica complexa com uma estrutura pensada só para guardar arquivo.
O Que é Cada Um, em uma Frase
Um Data Lake guarda o dado como ele chega: bruto, em qualquer formato, de qualquer fonte, sem exigir que a estrutura (o esquema) seja definida antes de guardar nada. Um Data Warehouse guarda o dado já modelado, estruturado para um tipo de consulta específico, geralmente analítica ou de BI, com o esquema definido antes da carga.
Data Lake e Data Warehouse, Lado a Lado
| Característica | Data Lake | Data Warehouse |
|---|---|---|
| Dado aceito | Estruturado, semiestruturado e não estruturado | Dado relacional de sistemas transacionais |
| Esquema | Aplicado na hora da consulta (schema-on-read) | Definido antes da carga (schema-on-write), ou na consulta |
| Pré-processamento | Opcional; dá para guardar e decidir depois | Normalmente feito antes, por um processo de ETL |
| Performance | Prioriza volume e custo de armazenamento | Otimizado para a consulta mais rápida possível |
| Quem usa | Cientista de dados, engenheiro de dados, analista | Analista de negócio, cientista de dados |
A comparação oficial da AWS resume bem essa troca: o Data Warehouse entrega o resultado da consulta mais rápido, porque o dado já chegou organizado; o Data Lake entrega um volume muito maior de armazenamento a um custo menor, porque não exige organizar tudo antes de guardar.
Onde o Esquema do Dado é Definido
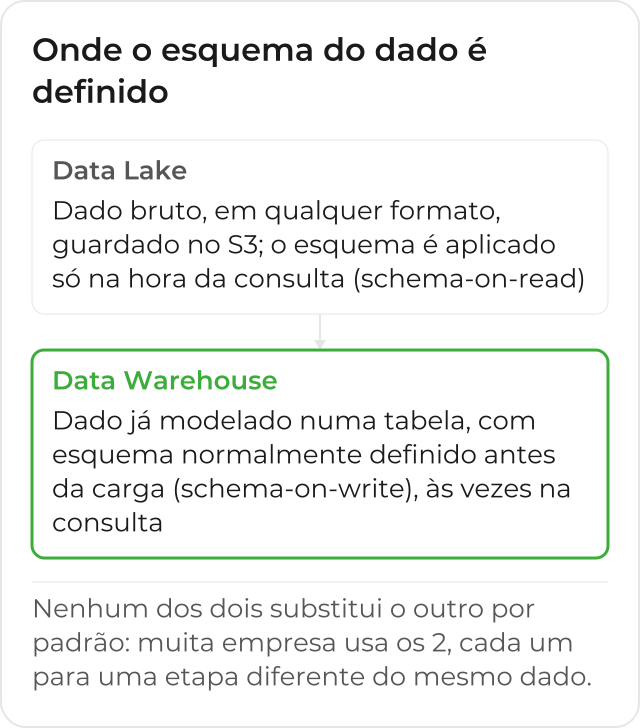
A diferença central, segundo a própria AWS, está em quando o esquema (a estrutura das colunas e tipos de dado) é definido. No Data Lake, isso acontece só no momento da consulta, o chamado schema-on-read: o dado entra como está e a estrutura é decidida depois, por quem vai consultar. No Data Warehouse, o esquema costuma ser definido antes da carga, embora também possa ser escrito na hora da análise em alguns casos.
Quando o Data Lake Resolve Melhor
Quando a empresa tem fontes de dados muito diferentes entre si (logs de aplicação, planilhas, dados de CRM, arquivos) e ainda não sabe exatamente como vai consultar tudo isso no futuro. O Data Lake guarda o dado bruto primeiro, para decidir a modelagem depois, sem descartar nada por não caber num formato fixo logo de início. É também o caminho natural quando o volume de dados é grande e o custo de armazenamento pesa na decisão, ou quando o time de dados ainda está explorando o que existe, antes de qualquer projeto de análise formal.
Um exemplo comum: uma empresa que recebe eventos de uso do produto, dados de um CRM e planilhas de controle financeiro, cada um num formato diferente. Guardar tudo bruto no Data Lake primeiro permite que o time explore esses dados juntos mais tarde, sem ter decidido de antemão qual pergunta cada fonte precisaria responder no dia em que ela chegou.
Quando o Data Warehouse Resolve Melhor
Quando a pergunta que o time de negócio precisa responder já é conhecida e repetida (um dashboard de vendas por região, por exemplo) e os dados de origem já são relativamente estruturados. O Data Warehouse entrega consulta rápida sobre um modelo já pronto para aquela pergunta, porque o trabalho de organizar o dado já foi feito antes, não a cada consulta nova.
Esse é o caso de um time financeiro que fecha o resultado do mês toda semana, sempre com as mesmas perguntas (receita por região, por produto, por canal): modelar o dado uma vez, de acordo com essas perguntas conhecidas, compensa o esforço de preparar o esquema antes da carga, porque a mesma estrutura é consultada repetidamente, sem precisar ser remontada a cada vez.
Dá para Ter os Dois
Muita empresa usa um Data Lake como a camada que recebe o dado bruto de tudo, e constrói um Data Warehouse (ou visões equivalentes) a partir dele para as consultas analíticas do dia a dia: um não substitui necessariamente o outro, cada um resolve uma etapa diferente do mesmo problema de dados. Na AWS, isso costuma significar dado bruto guardado no Amazon S3, organizado e com permissões controladas pelo AWS Lake Formation, e um recorte desse dado carregado num Data Warehouse como o Amazon Redshift para as consultas que precisam de resposta rápida. O Lake Formation centraliza o controle de acesso ao Data Lake no S3 e ao catálogo de metadados, com permissões detalhadas por coluna, linha ou célula, aplicadas em serviços de análise como o Amazon Athena e o próprio Redshift Spectrum, sem precisar repetir essa configuração em cada ferramenta separadamente.
Por Onde Costuma Começar
Se a sua empresa tem dados espalhados em sistemas diferentes e ainda não tem clareza de como vai usá-los, o ponto de partida costuma ser o diagnóstico das fontes, não a escolha da arquitetura: só depois de saber o que existe, onde está e quem consulta, a decisão entre Data Lake, Data Warehouse ou os dois fica mais fácil de tomar com confiança.
Como Fica a Decisão do Seu Time
Depois desse diagnóstico, a pergunta deixa de ser “qual tecnologia é melhor” e passa a ser “qual pergunta de negócio essa estrutura precisa responder, e com que frequência”. Um time que sabe responder isso escolhe entre Data Lake, Data Warehouse ou os dois com a mesma clareza com que escolhe qualquer outra ferramenta: pelo problema que resolve, não pela moda do momento. E, se a resposta mudar daqui a um ano, a arquitetura certa é a que permite adicionar a outra peça depois, sem precisar recomeçar do zero.
Veja como funciona a consultoria de dados e Data Lake com AWS da CloudDog, do diagnóstico das fontes até a arquitetura certa para o que a sua empresa precisa consultar.
