
Su Equipo Ya Tiene el Dato, pero Todavía No Decidió Dónde Guardarlo
Toda empresa que empieza a organizar sus propios datos llega a una pregunta parecida: ¿el dato bruto, crudo, de cualquier lugar, o el dato ya ordenado, listo para la pregunta que el equipo de negocio hace cada mes? La respuesta no es “uno es mejor que el otro”: es entender qué pregunta su empresa necesita responder primero, y ahí elegir la pieza correcta para ese momento.
Es común que un equipo técnico elija la arquitectura antes de saber qué pregunta va a responder, porque Data Lake y Data Warehouse son términos que aparecen todo el tiempo en cualquier conversación sobre datos. El problema de elegir así es construir una estructura cara y sofisticada para una pregunta simple, o lo contrario: intentar responder una pregunta analítica compleja con una estructura pensada solo para guardar archivos.
Qué Es Cada Uno, en una Frase
Un Data Lake guarda el dato como llega: bruto, en cualquier formato, de cualquier fuente, sin exigir que la estructura (el esquema) se defina antes de guardar nada. Un Data Warehouse guarda el dato ya modelado, estructurado para un tipo de consulta específico, generalmente analítica o de BI, con el esquema definido antes de la carga.
Data Lake y Data Warehouse, Lado a Lado
| Característica | Data Lake | Data Warehouse |
|---|---|---|
| Dato aceptado | Estructurado, semiestructurado y no estructurado | Dato relacional de sistemas transaccionales |
| Esquema | Aplicado al momento de la consulta (schema-on-read) | Definido antes de la carga (schema-on-write), o en la consulta |
| Preprocesamiento | Opcional; se puede guardar y decidir después | Normalmente hecho antes, por un proceso de ETL |
| Rendimiento | Prioriza volumen y costo de almacenamiento | Optimizado para la consulta más rápida posible |
| Quién lo usa | Científico de datos, ingeniero de datos, analista | Analista de negocio, científico de datos |
La comparación oficial de AWS resume bien este intercambio: el Data Warehouse entrega el resultado de la consulta más rápido, porque el dato ya llegó organizado; el Data Lake entrega un volumen mucho mayor de almacenamiento a un costo menor, porque no exige organizar todo antes de guardarlo.
Dónde Se Define el Esquema del Dato
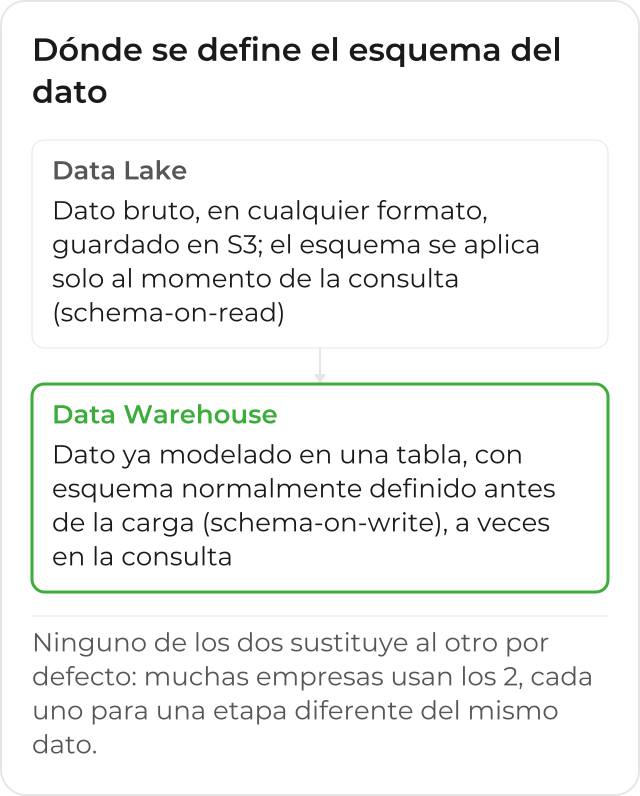
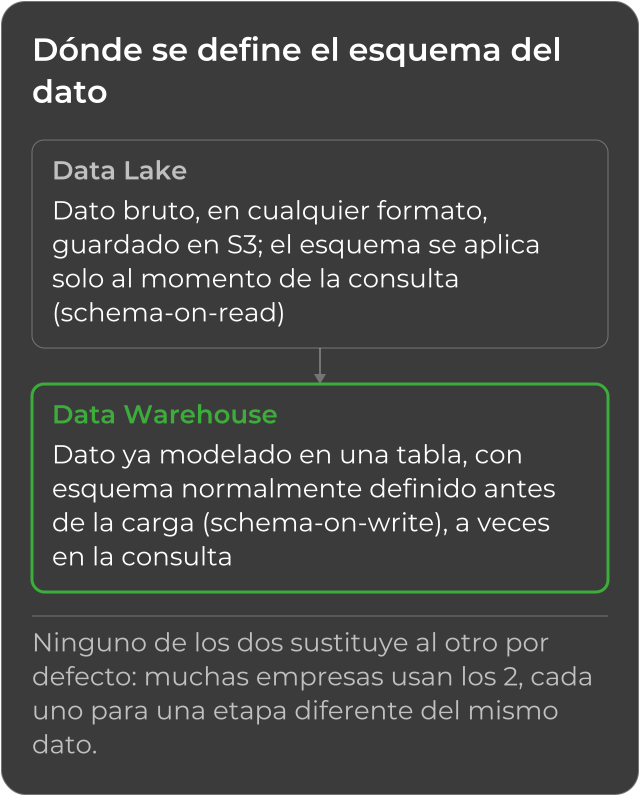
La diferencia central, según la propia AWS, está en cuándo se define el esquema (la estructura de columnas y tipos de dato). En el Data Lake, eso sucede solo al momento de la consulta, el llamado schema-on-read: el dato entra como está y la estructura se decide después, por quien va a consultarlo. En el Data Warehouse, el esquema suele definirse antes de la carga, aunque también puede escribirse al momento del análisis en algunos casos.
Cuándo el Data Lake Resuelve Mejor
Cuando la empresa tiene fuentes de datos muy diferentes entre sí (logs de aplicación, hojas de cálculo, datos de CRM, archivos) y todavía no sabe exactamente cómo va a consultar todo eso en el futuro. El Data Lake guarda el dato bruto primero, para decidir el modelado después, sin descartar nada por no encajar en un formato fijo desde el inicio. También es el camino natural cuando el volumen de datos es grande y el costo de almacenamiento pesa en la decisión, o cuando el equipo de datos todavía está explorando lo que existe, antes de cualquier proyecto de análisis formal.
Un ejemplo común: una empresa que recibe eventos de uso del producto, datos de un CRM y hojas de cálculo de control financiero, cada uno en un formato diferente. Guardar todo bruto en el Data Lake primero permite que el equipo explore esos datos juntos más tarde, sin haber decidido de antemano qué pregunta cada fuente necesitaría responder el día en que llegó.
Cuándo el Data Warehouse Resuelve Mejor
Cuando la pregunta que el equipo de negocio necesita responder ya es conocida y repetida (un dashboard de ventas por región, por ejemplo) y los datos de origen ya son relativamente estructurados. El Data Warehouse entrega consulta rápida sobre un modelo ya listo para esa pregunta, porque el trabajo de organizar el dato ya se hizo antes, no en cada consulta nueva.
Ese es el caso de un equipo financiero que cierra el resultado del mes cada semana, siempre con las mismas preguntas (ingresos por región, por producto, por canal): modelar el dato una vez, de acuerdo con esas preguntas conocidas, compensa el esfuerzo de preparar el esquema antes de la carga, porque la misma estructura se consulta repetidamente, sin necesitar rearmarse cada vez.
Se Puede Tener los Dos
Muchas empresas usan un Data Lake como la capa que recibe el dato bruto de todo, y construyen un Data Warehouse (o vistas equivalentes) a partir de él para las consultas analíticas del día a día: uno no sustituye necesariamente al otro, cada uno resuelve una etapa diferente del mismo problema de datos. En AWS, eso suele significar dato bruto guardado en Amazon S3, organizado y con permisos controlados por AWS Lake Formation, y un recorte de ese dato cargado en un Data Warehouse como Amazon Redshift para las consultas que necesitan respuesta rápida. El Lake Formation centraliza el control de acceso al Data Lake en S3 y al catálogo de metadatos, con permisos detallados por columna, fila o celda, aplicados en servicios de análisis como Amazon Athena y el propio Redshift Spectrum, sin necesitar repetir esa configuración en cada herramienta por separado.
Por Dónde Suele Empezar
Si su empresa tiene datos dispersos en sistemas diferentes y todavía no tiene claridad de cómo va a usarlos, el punto de partida suele ser el diagnóstico de las fuentes, no la elección de la arquitectura: solo después de saber qué existe, dónde está y quién consulta, la decisión entre Data Lake, Data Warehouse o los dos queda más fácil de tomar con confianza.
Cómo Queda la Decisión de Su Equipo
Después de ese diagnóstico, la pregunta deja de ser “qué tecnología es mejor” y pasa a ser “qué pregunta de negocio esta estructura necesita responder, y con qué frecuencia”. Un equipo que sabe responder eso elige entre Data Lake, Data Warehouse o los dos con la misma claridad con que elige cualquier otra herramienta: por el problema que resuelve, no por la moda del momento. Y, si la respuesta cambia dentro de un año, la arquitectura correcta es la que permite agregar la otra pieza después, sin necesitar empezar de cero.
Vea cómo funciona la consultoría de datos y Data Lake con AWS de CloudDog, del diagnóstico de las fuentes hasta la arquitectura correcta para lo que su empresa necesita consultar.
